Codex 스킬을 고칠 때 느낌만으로 좋아졌다고 판단하기 어렵다면, 대표 요청을 실행하고 실제 행동과 결과를 비교하는 작은 평가 묶음을 만들면 됩니다. OpenAI가 2026년 1월 22일 공개한 안내는 성공 기준을 먼저 정하고, 실행 기록과 산출물에 간단한 검사를 적용해 스킬의 회귀를 찾는 흐름을 제시했습니다.
간단 요약
- 먼저 스킬이 해야 할 행동을 측정 가능한 기준으로 정의
- 정상 요청·누락 정보·예외·범위 밖 요청을 준비
- 결과 파일과 실행 기록을 함께 확인
- 기계적 검사와 사람의 판단을 필요한 만큼 결합
1. 무엇을 평가할까
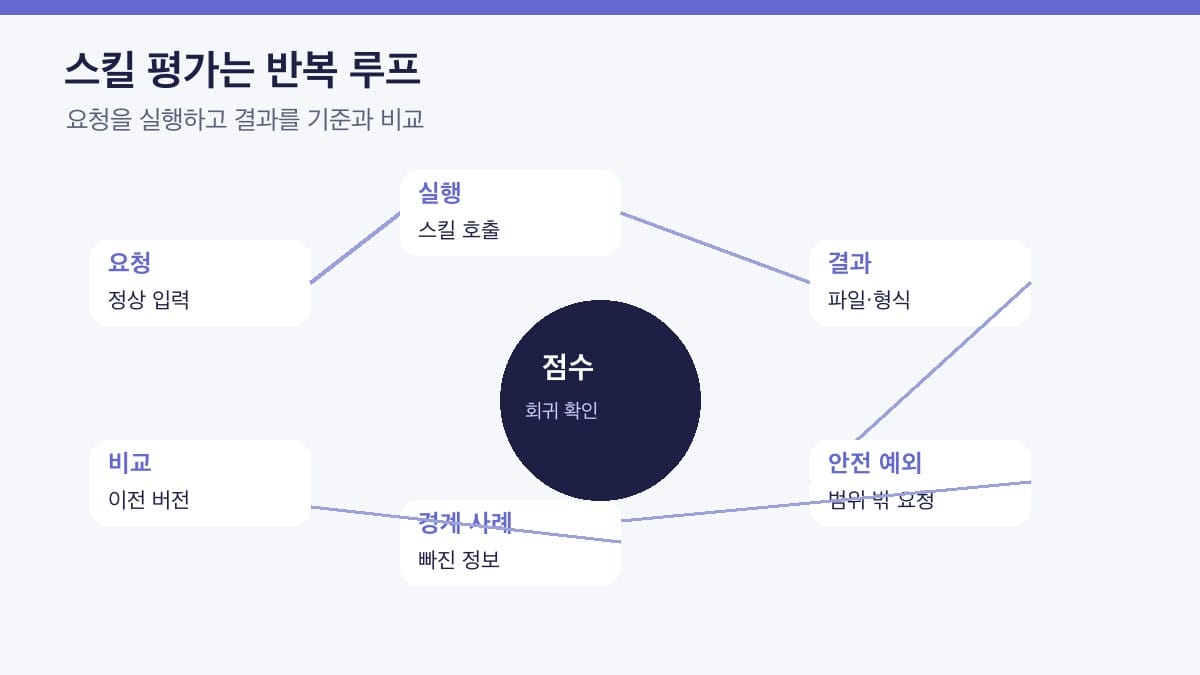
스킬은 반복 작업의 절차를 설명하므로 결과 문장만 읽어서는 충분하지 않습니다. 요청에서 스킬이 올바르게 활성화됐는지, 필요한 명령을 실행했는지, 산출물이 정해 둔 형식에 맞는지 확인해야 합니다. OpenAI 글은 요청, 실행 기록과 결과물, 검사, 비교할 점수의 순환 구조로 설명합니다.
2. 1단계: 기대 행동을 먼저 적기
스킬을 작성하거나 고치기 전에 성공 기준부터 정합니다. 예를 들어 요청 키워드가 있으면 해당 절차를 시작하고, 필수 산출물은 지정한 폴더에 저장하고, 빠진 입력이 있을 때는 임의로 지어내지 않는 식입니다. 기준이 모호하면 결과가 나왔어도 무엇이 개선되었는지 평가할 수 없습니다.
첫 사례는 정상 요청으로 기본 흐름을 확인합니다. 둘째는 필수 정보가 빠진 경계 사례, 셋째는 안전한 범위를 벗어난 요청, 넷째는 비슷한 표현이지만 스킬과 무관한 요청입니다. 이 구성이면 스킬이 필요한 때 작동하는지와 불필요할 때 끼어들지 않는지를 함께 볼 수 있습니다.
3. 3단계: 결과뿐 아니라 흔적도 보기
산출물이 맞아 보여도 에이전트가 중간 절차를 건너뛰었을 수 있습니다. 실행 기록을 보면 필요한 도구와 명령을 사용했는지 확인할 수 있고, 결과 파일을 보면 경로·형식·필수 항목을 검사할 수 있습니다. OpenAI 가이드는 Codex 실행 기록의 JSON 출력과 구조화된 결과 형식을 이용해 자동 비교를 구성하는 예를 소개합니다.
내 경우 판단 순서
- 정상 요청과 정보 누락 요청을 정합니다.
- 파일·형식 같은 기계적 기준을 자동 검사합니다.
- 이전 버전과 예외 처리 결과도 같이 비교합니다.
4. 4단계: 결정론적 검사부터 시작하기
파일 존재 여부, JSON 스키마, 금지 문자열, 출력 개수처럼 명확한 조건은 스크립트로 검사할 수 있습니다. 자연스러운 설명이나 판단의 질처럼 숫자 하나로 고정하기 어려운 항목은 짧은 평가 기준표를 써서 사람 또는 별도 평가 단계가 살펴보게 할 수 있습니다. 모든 기준을 모델 평가에 맡기기보다 간단한 검사를 먼저 자동화하는 편이 해석하기 쉽습니다.
스킬을 수정했다면 같은 요청 묶음으로 이전 버전과 새 버전을 실행합니다. 정상 요청 성공률이 올라도 예외 요청을 잘못 처리하거나 파일을 더 만드는 회귀가 생길 수 있습니다. 속도나 실행 명령 횟수를 볼 때도 정답 여부와 안전 경계를 함께 기록해야 한 지표의 개선을 전체 품질로 착각하지 않습니다.
Codex 스킬 평가표에는 기대 결과와 실패로 볼 조건을 함께 적습니다. 예를 들어 올바른 폴더에 파일이 있어야 한다면 파일 이름만 확인하지 말고, 필수 항목과 불필요한 파일 생성 여부도 나눠 검사하세요. 프롬프트의 표현이 달라져도 핵심 행동이 유지되는지 확인하려면 같은 의도를 가진 짧은 변형 요청을 추가할 수 있습니다. 사례를 너무 많이 모으기보다 서로 다른 오류 유형을 잡는지 주기적으로 정리하세요.
점수는 팀이 중요하게 여기는 행동을 비교하기 위한 신호이지, 스킬이 완벽하다는 인증은 아닙니다. 새 사례에서 실패했을 때 왜 틀렸는지 사람이 읽을 수 있도록 요청, 기대값, 실제 결과를 함께 저장하세요. 결과만 남기면 다음 수정에서 같은 경계 조건을 놓치기 쉽습니다.
5. 첫 평가표 예시
스킬이 결과 보고서를 만드는 작업이라면 제목, 저장 위치, 필수 항목을 자동으로 점검할 수 있습니다. 그러나 근거가 요청 자료에 실제로 있는지, 예외를 올바르게 처리했는지는 별도 판단 기준으로 둡니다. 정상 입력·누락 정보·범위 밖 요청에서 서로 다른 기대 행동을 명시해야 점수가 행동의 차이를 반영합니다.
수동으로 고치게 만든 결과는 다음 평가에서 다시 확인할 가치가 있습니다. 스킬 설명을 바꿔 특정 요청에서 호출되지 않았던 문제를 고쳤다면, 같은 요청을 회귀 사례로 보관합니다. 반대로 표현만 다른 중복 프롬프트가 너무 많으면 평가 묶음을 관리하기 어려우므로, 실제로 다른 실패 유형을 드러내는 최소 세트로 유지하세요.
✅ 결론
스킬을 평가하는 가장 쉬운 출발점은 대표 요청 몇 개를 고정하고, 그 결과에서 꼭 지켜야 할 조건을 검사하는 것입니다. 자동화하기 쉬운 항목부터 점수화하고, 사람의 판단이 필요한 항목은 짧은 기준표로 남겨 이전 버전과 같은 조건에서 비교해 보세요.
자료 출처 OpenAI Developers, 「Testing Agent Skills Systematically with Evals」(2026년 1월 22일) 확인 기준. 기능과 안내는 변경될 수 있습니다.
FAQ — 자주 묻는 질문
Q1. 스킬 평가는 모델의 답변 문장만 보면 되나요?
아닙니다. 스킬 호출 여부, 실행한 도구·명령, 만든 파일과 그 형식을 함께 봐야 합니다. 최종 답변은 중간 절차의 누락을 가릴 수 있습니다.
Q2. 평가 사례는 몇 개가 적당한가요?
고정된 정답 개수는 없습니다. 먼저 정상 흐름과 가장 자주 발생하는 경계·예외 상황을 대표하는 소수 사례로 시작하고, 실제 실패를 발견할 때 추가하는 방식이 관리하기 쉽습니다.
Q3. 모든 평가를 자동화해야 하나요?
파일 형식이나 필수 항목처럼 명확한 기준은 자동 검사에 적합합니다. 근거의 충분성이나 안전한 판단처럼 맥락이 필요한 항목은 별도의 평가 기준을 함께 쓸 수 있습니다.
※ 이 글은 2026년 9월 29일 기준 OpenAI 공식 안내를 바탕으로 작성한 정보성 해설입니다. 제품 기능과 운영 방식은 바뀔 수 있으며, 실제 저장소 적용과 코드 변경 결과는 프로젝트 환경에서 별도로 검토해야 합니다.